Parametri avanzati del RAG
A chi si rivolge questa pagina
I parametri descritti in questa pagina si trovano nella configurazione della base di conoscenza, sia nel form di creazione sia in Impostazioni. La pagina descrive inoltre come la piattaforma sceglie i contenuti da fornire all'agente, un flusso uguale per tutti gli agenti che non si regola dalla configurazione dell'agente. È pensata per chi amministra l'organizzazione e desidera capire come migliorare la qualità delle risposte; per la spiegazione generale del funzionamento del RAG vedere Come funziona il RAG.
Suddivisione in frammenti (chunking)
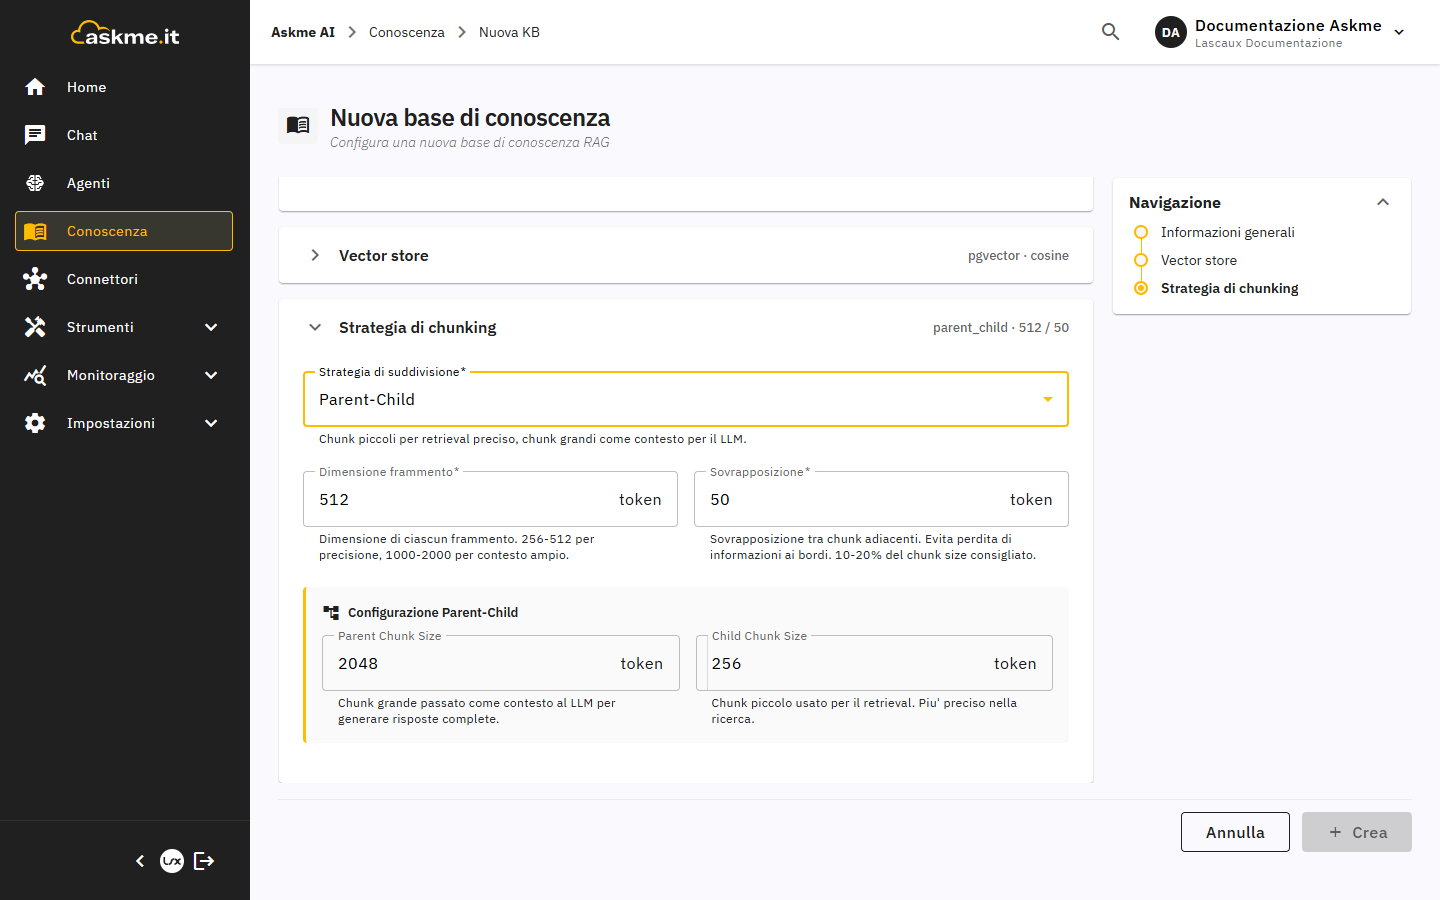
Prima di essere indicizzato, ogni documento viene suddiviso in frammenti di testo più piccoli ("chunk"), perché è su questi frammenti che avviene la ricerca. La strategia si sceglie in fase di creazione della base di conoscenza e si può cambiare in Impostazioni > Indicizzazione. Il form di creazione mostra le strategie con i nomi inglesi, le impostazioni con quelli italiani:
| Strategia | Come divide il testo |
|---|---|
| Fixed Size (Fissa) | Frammenti di lunghezza costante, indipendentemente dalla struttura del testo |
| Recursive (Ricorsiva) | Rispetta per quanto possibile paragrafi e frasi, riducendo la dimensione solo dove necessario. È la strategia predefinita |
| Semantic (Semantica) | Raggruppa le frasi per affinità di significato, con frammenti di lunghezza variabile |
| Parent-Child (Padre-figlio) | Indicizza frammenti piccoli per la ricerca, ma fornisce all'agente il frammento "genitore" più ampio come contesto |
La suddivisione è regolata da questi parametri, espressi in token:
| Parametro | Intervallo | Indicazioni |
|---|---|---|
| Dimensione frammento | 100-4.000 (predefinito 512) | Frammenti da 256-512 token favoriscono la precisione del recupero, frammenti da 1.000-2.000 token mantengono più contesto insieme |
| Sovrapposizione | 0-1.000 (predefinito 50) | Testo condiviso fra un frammento e il successivo, per evitare che un concetto venga tagliato al confine; consigliato il 10-20% della dimensione del frammento |
| Parent Chunk Size | 512-8.000 (predefinito 2.048) | Solo Parent-Child: frammento ampio fornito come contesto |
| Child Chunk Size | 64-1.024 (predefinito 256) | Solo Parent-Child: frammento piccolo usato per la ricerca |
Quando la base di conoscenza usa la strategia Fixed Size o Recursive, le pagine acquisite dai siti web vengono indicizzate con la strategia Semantic, più efficace sul testo proveniente da pagine HTML. Con le strategie Semantic e Parent-Child le pagine web seguono la strategia scelta.
Ogni frammento che prosegue una sezione riceve inoltre un'intestazione contestuale automatica (ad esempio [Sezione: Condizioni di reso]), che aiuta il recupero a comprendere da quale parte del documento proviene anche quando il frammento viene estratto isolatamente. L'interruttore Aggiungi titolo e contesto a ogni frammento (Arricchimento contestuale), presente in Impostazioni > Indicizzazione, va lasciato nello stato proposto.
Le modifiche ai parametri di suddivisione valgono per i contenuti elaborati dopo il salvataggio.
Come vengono scelti i contenuti
A ogni domanda la piattaforma esegue lo stesso flusso per tutti gli agenti.
- Riformulazione della domanda. Quando la conversazione è già avviata, la domanda viene riformulata in forma autonoma, così che un seguito come «e gli orari?» diventi una richiesta completa. Le Istruzioni di riscrittura dell'agente orientano questa riformulazione (vedere Conoscenza dell'agente). Alla prima domanda di una conversazione la ricerca usa il testo così come è stato scritto.
- Ricerca ibrida. Una ricerca per significato e una ricerca per corrispondenza di parole individuano nelle basi di conoscenza collegate un primo insieme di frammenti candidati, fondendo i due elenchi di risultati. La componente per parole applica le regole morfologiche della lingua dichiarata dalla base (vedere Lingue della base), ed è quella che recupera meglio codici prodotto, sigle e numeri di pratica.
- Riordino. Un modello dedicato rilegge i candidati e li riordina in base alla pertinenza rispetto alla domanda. Il riordino si applica quando i frammenti di tutte le basi collegate sono abbastanza brevi da essere letti per intero dal modello di riordino, cioè fino a 256 token con la configurazione standard. Con frammenti più lunghi, come con la dimensione predefinita di 512 token, resta l'ordine della ricerca ibrida.
- Controllo di pertinenza. Il risultato migliore viene classificato in una di tre zone. Se i contenuti sono pertinenti, i migliori vengono forniti all'agente, fino al numero indicato nei Passaggi nel contesto dell'agente o, se il campo è vuoto, al massimo stabilito per l'organizzazione. Se sono incerti, cioè solo parzialmente pertinenti, la piattaforma ripete una sola volta la ricerca con una formulazione diversa della domanda e tiene il migliore dei due tentativi. Se non sono pertinenti, all'agente non viene fornito alcun contenuto della base di conoscenza (vedere Quando la conoscenza non basta). Senza riordino le zone sono solo due, pertinente e non pertinente, e il nuovo tentativo non viene eseguito.
Il numero di risultati, la soglia di pertinenza e il riordino non si regolano sull'agente. Il numero massimo di contenuti forniti all'agente è un'impostazione dell'organizzazione, gestita dal team Askme, che il singolo agente può sostituire con il campo Passaggi nel contesto della sezione Conoscenza. Con la Ricerca autonoma nella conoscenza attiva, l'agente può inoltre ripetere la ricerca mentre risponde, con lo stesso flusso e lo stesso controllo di pertinenza (vedere Conoscenza dell'agente).
Il punteggio di Pertinenza mostrato accanto a ogni fonte riflette questo flusso: con il riordino esprime la pertinenza stimata del frammento rispetto alla domanda; senza riordino è il punteggio della ricerca, con valori molto più bassi, utile solo per confrontare fra loro le fonti di una stessa risposta.
Valori di recupero della base di conoscenza
In Impostazioni > Recupero ogni base di conoscenza riporta, in sola lettura, alcuni valori registrati alla creazione (Risultati, Soglia di somiglianza, Funzione di distanza, HyDE, Quantizzazione binaria). Il recupero delle risposte degli agenti non li utilizza: segue il flusso descritto nella sezione precedente.
Lingue della base
Una base di conoscenza può avere più lingue dichiarate; la prima è la lingua principale della base, usata per l'indice testuale della ricerca per parole. La ricerca semantica è multilingue: le domande in altre lingue trovano i contenuti senza traduzione, perché la ricerca per significato confronta i testi indipendentemente dalla lingua in cui sono scritti. Le lingue si impostano nel campo Lingue dei contenuti del form di creazione e in Impostazioni > Generali. Cambiando la prima lingua di una base esistente, l'indice usato dalla ricerca per parole viene ricalcolato nella nuova lingua.
Valori consigliati per scenari tipici
| Scenario | Suddivisione |
|---|---|
| FAQ e supporto clienti, risposte brevi | Recursive, 256 token, sovrapposizione 10-20%: frammenti di questa dimensione vengono anche riordinati per pertinenza |
| Documentazione tecnica o contrattuale, contenuti lunghi | Parent-Child, oppure Recursive con 1.000-2.000 token per mantenere più contesto insieme |
| Base di conoscenza multilingua | Semantic, con tutte le lingue dei contenuti dichiarate nella base |
I valori in tabella sono punti di partenza da verificare e affinare osservando le risposte reali e le fonti recuperate (vedere Anteprima chat). Le modifiche alla suddivisione valgono per i contenuti elaborati dopo il salvataggio: per applicarle ai contenuti esistenti occorre reindicizzarli.